
Google no solo busca que la inteligencia artificial procese información más rápido.
- Los agentes de IA necesitan algo más que respuestas rápidas
- TPU 8tx: cómo proteger información mientras la IA la utiliza
- TPU 8i Max: cuando la IA necesita una mesa de trabajo más grande
- Google no inventó dos chips desde cero y ahí está otra novedad
- ¿Qué cambia para quienes utilizan agentes de IA?
- ¿Sabías que?
Pedirle a una inteligencia artificial que resuma un documento es una cosa. Ahora imagina encargarle que revise miles de archivos, encuentre errores en un programa, consulte información confidencial y complete varias tareas sin que tengas que decirle qué hacer en cada paso. Suena bastante útil, ¿verdad? El problema es que toda esa autonomía viene acompañada de dos dolores de cabeza: la cantidad de información que debe manejar y cómo proteger los datos mientras trabaja.
Google quiere enfrentarse a esos desafíos con dos nuevos sistemas de procesamiento de inteligencia artificial llamados TPU 8tx y TPU 8i Max, anunciados el 9 de noviembre. Ambos amplían su familia de procesadores de octava generación, pero cada uno tiene una misión diferente: uno está diseñado para proteger información confidencial durante su procesamiento y el otro para trabajar con enormes cantidades de datos sin que la memoria se convierta en un obstáculo.
Más datos: Google abre su nube a OpenAI: ¿qué ganas con esta alianza entre “rivales”?
Y aquí aparece un detalle interesante: Google no tuvo que comenzar desde cero para desarrollarlos. En lugar de diseñar dos chips completamente nuevos, reorganizó tecnologías que ya tenía para responder a las necesidades de una IA que está dejando de limitarse a conversar y comienza a ejecutar tareas cada vez más complejas.
Los agentes de IA necesitan algo más que respuestas rápidas
Para entender por qué Google está haciendo estos cambios, primero tenemos que hablar de los agentes de inteligencia artificial.
Seguramente ya estás familiarizado con los asistentes a los que les haces una pregunta y recibes una respuesta. Los agentes van un paso más allá: pueden organizar tareas en diferentes etapas, utilizar herramientas, consultar información y ejecutar acciones para intentar cumplir un objetivo.
Por ejemplo, un agente de programación podría recibir el encargo de revisar un proyecto completo, analizar archivos, identificar posibles errores y proponer correcciones. Durante ese trabajo tendría que consultar información constantemente, relacionar diferentes partes del código y mantener suficiente contexto para no perder el hilo.
Ahora multiplica ese escenario por decenas de agentes trabajando simultáneamente. Ahí es cuando aparecen los problemas de memoria, velocidad y seguridad que Google quiere resolver.
Para ello utiliza sus TPU, sigla de Tensor Processing Unit, unos procesadores especializados en las operaciones matemáticas que necesitan los sistemas de inteligencia artificial.
Otros datos: Sin títulos ni requisitos: cómo Google y el Gobierno formarán a colombianos en habilidades tech
A diferencia de los chips que encuentras en un computador convencional, estas unidades están diseñadas para trabajar en infraestructura de gran escala. Google las utiliza para entrenar y ejecutar sus modelos Gemini, además de ofrecer capacidad de procesamiento a clientes de Google Cloud.
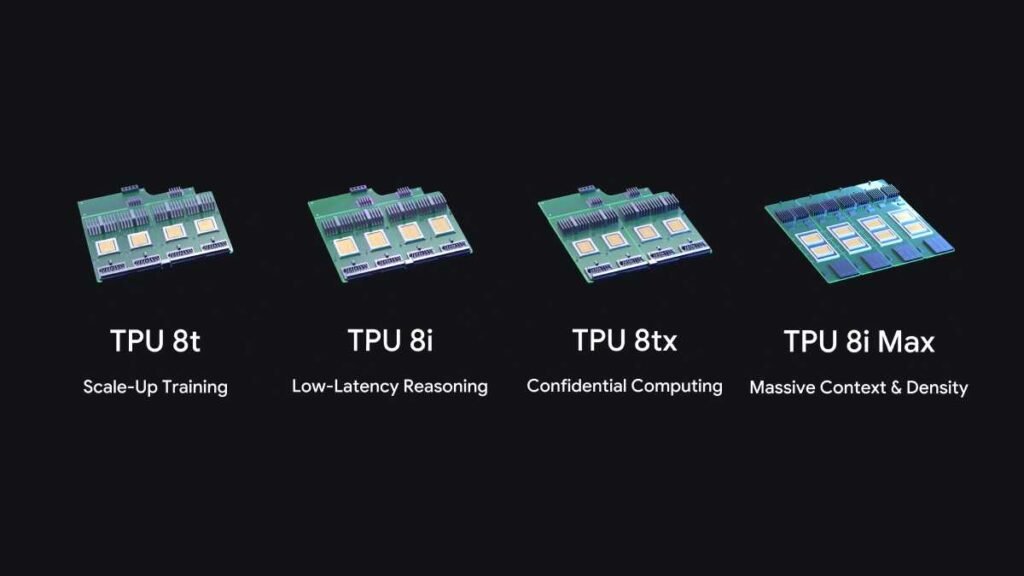
Con el anuncio de sus dos nuevos sistemas, la octava generación queda compuesta por cuatro configuraciones: TPU 8t, orientada al entrenamiento de grandes modelos; TPU 8i, enfocada en inferencia y razonamiento de baja latencia; y las nuevas TPU 8tx y TPU 8i Max.
La inferencia, por cierto, es el trabajo que realiza un modelo cuando utiliza lo aprendido para generar una respuesta o realizar una tarea. Es diferente del entrenamiento, que es el proceso mediante el cual el modelo aprende patrones a partir de datos.
Pero ¿qué tienen de especial las dos nuevas configuraciones?
TPU 8tx: cómo proteger información mientras la IA la utiliza
Aquí tenemos un problema de seguridad que seguramente no habías considerado.
Cuando guardas un archivo confidencial en un sistema informático, puedes protegerlo mediante cifrado. Lo mismo ocurre cuando la información viaja por una red. Sin embargo, cuando un procesador necesita trabajar con esos datos, normalmente debe acceder a ellos en una forma que pueda interpretar.
Más datos: Google cambia las reglas de Gemini: ¿qué pasará con tus Gems?
Es como tener documentos importantes guardados en una caja fuerte. Mientras permanecen allí, están protegidos, pero en algún momento necesitas sacarlos para consultarlos. Y precisamente durante ese proceso también quieres evitar que otras personas accedan a su contenido.
Algo parecido sucede con la inteligencia artificial.
Pensemos en una entidad financiera que utiliza un agente para analizar documentación interna. El sistema necesita consultar archivos sensibles para realizar su trabajo, pero la organización también debe protegerlos frente a accesos no autorizados.
Ahí entra en escena la TPU 8tx, una configuración que incorpora mecanismos de computación confidencial respaldados por hardware.
Según Google, el sistema permite mantener protegidos y aislados tanto los datos sensibles como los parámetros de los modelos mientras están siendo utilizados.
Para lograrlo, combina el mismo silicio de TPU 8t con procesadores AMD EPYC de quinta generación y una arquitectura de seguridad especializada.
También incorpora una red de comunicación llamada Boardfly, diseñada para reducir los tiempos que necesitan los componentes para intercambiar información. Google asegura que esta configuración puede ofrecer hasta la mitad de la latencia de TPU 8t en determinadas cargas de trabajo, con una penalización de rendimiento prácticamente nula.
¿Y eso qué significa?
Que un agente encargado de ejecutar varias operaciones consecutivas podría beneficiarse de comunicaciones más rápidas entre los componentes del sistema, mientras la infraestructura incorpora protecciones para la información que está procesando.
Más datos: Esta herramienta de Google cumple 25 años y probablemente la usas todos los días
La TPU 8tx también está diseñada para permitir que las organizaciones ejecuten modelos y los ajusten con sus propios datos dentro del mismo sistema, sin tener que trasladar continuamente esa información confidencial entre diferentes grupos de servidores.
Eso sí, no significa que la IA se vuelva imposible de atacar o que sus datos estén automáticamente a salvo de cualquier riesgo. La seguridad también depende de los programas utilizados, los permisos de acceso y las medidas que adopte cada organización.
Lo importante es que Google está incorporando parte de esa protección directamente en la infraestructura que ejecuta la inteligencia artificial.
TPU 8i Max: cuando la IA necesita una mesa de trabajo más grande
Ahora pasemos al segundo problema, que tiene menos que ver con la privacidad y mucho más con la cantidad de información que un agente necesita utilizar.
Piensa en alguien que debe revisar cientos de documentos para preparar un informe. Puede ser una persona increíblemente rápida leyendo, pero si su escritorio es demasiado pequeño y tiene que levantarse constantemente a buscar carpetas, parte de su tiempo se perderá moviendo información de un lugar a otro.
Algo parecido puede suceder con los procesadores de IA.
No basta con tener una enorme capacidad de cálculo. También necesitas que los datos estén disponibles a suficiente velocidad para que los procesadores puedan trabajar sin pasar demasiado tiempo esperando.
Google llama a este desafío el “muro de memoria”, y su respuesta es TPU 8i Max.
La compañía tomó dos chips TPU 8i y los integró en un mismo encapsulado. Según sus especificaciones, esta configuración ofrece el doble de capacidad de cómputo, el doble de memoria SRAM y el doble de ancho de banda de memoria HBM frente a TPU 8i.
¿Y para qué sirve todo eso?
La SRAM es una memoria muy rápida utilizada cerca de los circuitos de procesamiento. Por su parte, la HBM es memoria de alto ancho de banda, diseñada para mover grandes cantidades de información hacia los procesadores con rapidez.
Al incrementar estos recursos, Google busca que sus sistemas puedan manejar cargas de trabajo más exigentes sin que el movimiento de información se convierta en un freno.
Esto cobra especial importancia cuando hablamos de ventanas de contexto de hasta un millón de tokens.
Los tokens son las unidades en las que un modelo divide el texto que procesa. Pueden representar palabras, fragmentos de palabras o signos, según el sistema utilizado.
Una ventana de contexto amplia permite que un modelo trabaje con mayores cantidades de información dentro de una misma operación. Eso resulta relevante para agentes que deben consultar grandes proyectos de programación, documentos extensos o información extraída de horas de video.
Sin embargo, hay una diferencia importante: tener más memoria y capacidad de procesamiento no significa que una IA automáticamente se vuelva más inteligente.
Tampoco garantiza que cualquier modelo pueda utilizar un millón de tokens o que sus respuestas sean correctas por el simple hecho de manejar más información. El resultado depende de las capacidades del modelo, el software y la configuración de toda la infraestructura.
Lo que Google está anunciando es un sistema diseñado para reducir algunas de las limitaciones técnicas que aparecen cuando esas tareas crecen.
Google no inventó dos chips desde cero y ahí está otra novedad
Hay otro aspecto interesante detrás de este lanzamiento: la forma en que Google está desarrollando su infraestructura de inteligencia artificial.
Diseñar un procesador completamente nuevo puede tomar años. Hay que definir su arquitectura, fabricar el silicio, realizar pruebas y preparar los sistemas que permitirán utilizarlo.
Pero las necesidades de la IA están cambiando mucho más rápido.
Por eso, Google está apostando por una arquitectura modular. En lugar de modificar el diseño fundamental de cada procesador, puede combinar de diferentes maneras los chips, la memoria, las conexiones de red y los sistemas de seguridad.
Eso es precisamente lo que ocurre con TPU 8tx y TPU 8i Max.
La primera aprovecha el silicio de TPU 8t y lo integra con componentes diseñados para favorecer la computación confidencial. La segunda combina dos chips TPU 8i para aumentar los recursos disponibles para trabajos que exigen grandes cantidades de información.
Es una estrategia que permite construir sistemas especializados sin tener que empezar cada desarrollo desde una hoja en blanco.
De hecho, Google asegura que esta aproximación le permite crear configuraciones de supercomputación especializadas en cuestión de meses, en lugar de años.
La compañía también está trabajando para facilitar que los desarrolladores utilicen sus procesadores. En octubre anunció que TorchTPU se convertía en un proyecto de código abierto, con el objetivo de facilitar la ejecución de aplicaciones desarrolladas con PyTorch, una de las herramientas más utilizadas para crear modelos de inteligencia artificial.
La intención es que aprovechar esta infraestructura no implique tener que reconstruir por completo las herramientas con las que ya trabajan muchos equipos de desarrollo.
¿Qué cambia para quienes utilizan agentes de IA?
Si utilizas Gemini u otro asistente de inteligencia artificial en tu celular, probablemente no vas a notar inmediatamente la llegada de estas nuevas TPU.
No estamos hablando de una actualización de una aplicación ni de una función que puedas activar desde un menú.
El cambio ocurre detrás de los servicios, en los centros de datos donde se ejecutan los modelos.
Sin embargo, sus posibles consecuencias son interesantes.
Para las empresas que utilizan agentes con información confidencial, la TPU 8tx incorpora una alternativa de procesamiento con protecciones de hardware específicas.
Para quienes desarrollan agentes que deben revisar proyectos enormes o mantener contextos extensos, TPU 8i Max ofrece una infraestructura con mayores recursos de memoria y cómputo.
Y para Google, esta expansión también representa una oportunidad de fortalecer su negocio de infraestructura. La compañía asegura que sus TPU ya cuentan con cerca de 100 clientes, entre laboratorios de inteligencia artificial, universidades, empresas comerciales y organizaciones de otros sectores.
Eso tampoco significa que todas estas organizaciones vayan a adoptar inmediatamente los nuevos sistemas. Google no anunció en su presentación una fecha única de disponibilidad general ni precios públicos para ambas configuraciones.
El verdadero impacto dependerá de cómo se implementen, qué resultados consigan en aplicaciones reales y si sus ventajas justifican el costo frente a otras alternativas.
Pero el anuncio deja algo claro sobre la dirección que está tomando la industria: a medida que los agentes de IA reciben tareas más complejas, construir mejores modelos ya no es suficiente. También necesitamos una infraestructura capaz de acompañarlos.
Porque una cosa es que una inteligencia artificial sepa qué hacer y otra muy diferente es que tenga la memoria, la velocidad y las protecciones necesarias para hacerlo.
¿Sabías que?
La historia de las TPU de Google tiene una conexión bastante interesante con los videojuegos y la inteligencia artificial. En 2016, la primera generación de estos procesadores ayudó a ejecutar AlphaGo, el sistema desarrollado por DeepMind que derrotó al jugador profesional Lee Sedol en una histórica serie de partidas de Go, un juego de estrategia que exige anticipar movimientos y evaluar innumerables posibilidades. AlphaGo ganó el enfrentamiento por cuatro partidas a una, en un momento que marcó un antes y un después en la historia de la IA.
Pero aquellas primeras TPU no se utilizaron únicamente para ese desafío. Google también las empleó para acelerar sistemas de su buscador, Google Translate y el análisis de imágenes de Google Photos, como documentó Google Research en su balance tecnológico de 2017. Una década después, esa familia de procesadores llega a su octava generación con un reto diferente: ayudar a que la inteligencia artificial no solo interprete información, sino que pueda trabajar con enormes cantidades de datos y realizar tareas cada vez más complejas.